เกริ่นนำ
PDF เป็นไฟล์ที่ผมเปิดแทบทุกวัน ใบเสร็จ สัญญา หนังสือราชการ ล้วนเป็น PDF
แต่พอจะแก้คำเดียว เรื่องกลับยาวครับ แก้ไม่ได้บ้าง แก้ได้แต่ตัวหนังสือห่างบ้าง คัดลอกภาษาไทยออกมาแล้วสระหาย วรรณยุกต์กลายเป็นสี่เหลี่ยมบ้าง
แล้วก็มีคำถามที่ได้ยินบ่อยว่า PDF เป็นของ Adobe ใช่ไหม ใช้โปรแกรมอื่นทำจะผิดหรือเปล่า
ผมเลยไล่อ่านเอกสารของ Adobe, ISO, PDF Association และเปิดกระทู้ Pantip ทีละกระทู้ แล้วมาเล่าตามลำดับ ตั้งแต่ PDF เกิดมายังไง ทำไมแก้ยาก เรื่องลิขสิทธิ์ Adobe อนุญาตอะไรบ้าง ไปจนถึงปัญหาที่คนไทยเจอจริง
บทความนี้ต่อจาก ฟอนต์หนังสือราชการไทย ที่ผมบอกไว้ว่าจะแยกมาเขียนเรื่อง PDF ครับ
อ่านสั้น ๆ
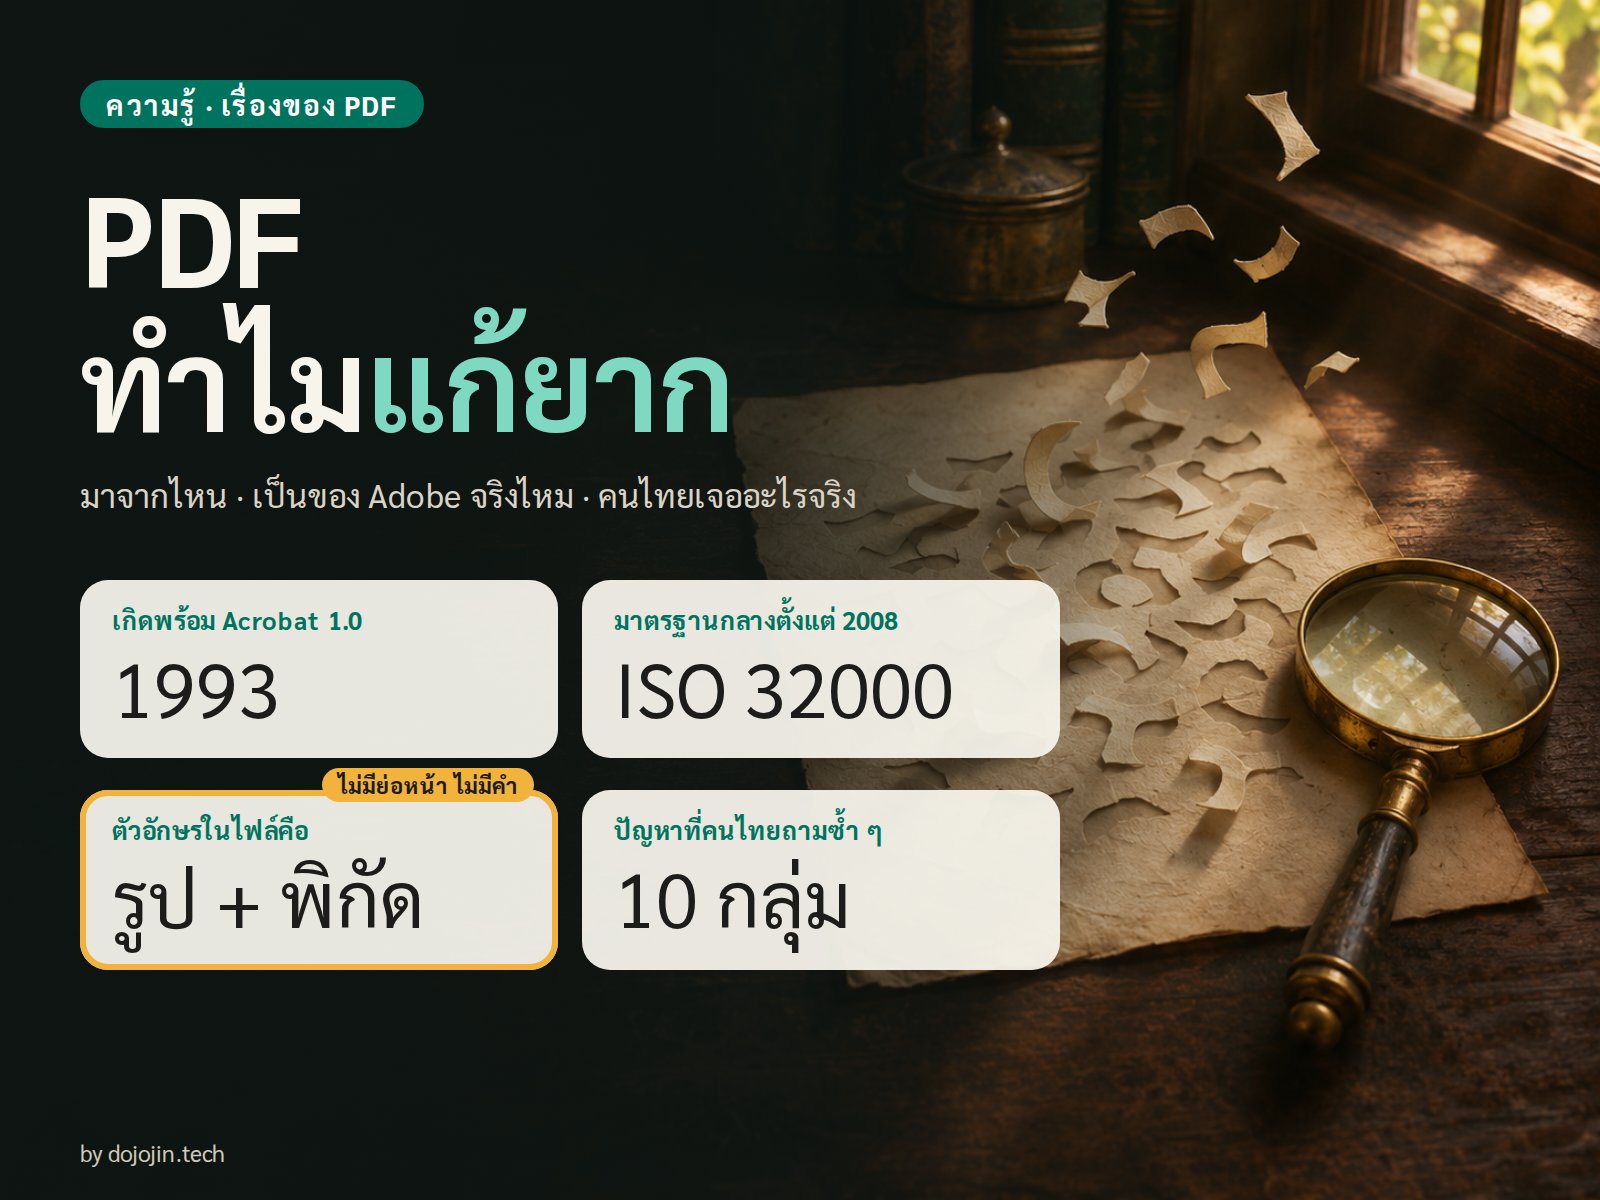
- Adobe คิด PDF จากโครงการ Camelot ของ John Warnock เปิดตัวพร้อม Acrobat 1.0 วันที่ 15 มิ.ย. 1993
- PDF ออกแบบมาให้หน้าตาเหมือนเดิมทุกเครื่อง ไม่ได้ออกแบบมาให้แก้
- ตั้งแต่ปี 2008 ตัวฟอร์แมตเป็นมาตรฐาน ISO 32000 ใครก็เขียนโปรแกรม PDF ได้
- ชื่อ Acrobat, Reader และโลโก้ Adobe PDF ยังเป็นเครื่องหมายการค้าของ Adobe
- ใน Pantip ปัญหาอันดับหนึ่งคือแปลงเป็น Word หรือคัดลอกแล้วภาษาไทยเพี้ยน
PDF มาจากไหน Adobe คิดขึ้นเมื่อปี 1990 เพื่อให้เอกสารหน้าตาเหมือนกันทุกเครื่อง
ก่อนจะมี PDF ต้องย้อนไปเล่าเรื่อง PostScript สั้น ๆ ก่อนครับ
ธันวาคม 1982 John Warnock กับ Chuck Geschke สองคนที่เคยทำงานอยู่ที่ Xerox PARC ออกมาตั้งบริษัทชื่อ Adobe แล้วปี 1984 ก็ออก PostScript ภาษาที่บอกเครื่องพิมพ์ว่าตัวหนังสือ เส้น และรูป ต้องวางตรงไหนบนหน้ากระดาษ
Adobe ขายสิทธิ์ PostScript ให้ทั้งบริษัทคอมพิวเตอร์และบริษัททำเครื่องพิมพ์ ตั้งแต่เลเซอร์พรินเตอร์ไปจนถึงเครื่องเรียงพิมพ์มืออาชีพ งานจัดหน้าบนคอมพิวเตอร์ หรือที่เรียกว่า desktop publishing ก็โตขึ้นมาจากตรงนี้ในยุค 80
ชื่อ Adobe ผูกกับงานพิมพ์และเอกสารมาตั้งแต่ตอนนั้น พอ PDF แตกออกมาจาก PostScript อีกที คนเลยเข้าใจกันมาตลอดว่า PDF เป็นของ Adobe ซึ่งก็ถูกแค่ครึ่งเดียว เดี๋ยวผมเล่าในหัวข้อลิขสิทธิ์ครับ
กลับมาที่ PDF Warnock อยากได้มากกว่าการสั่งเครื่องพิมพ์ เขาอยากให้เอกสารอะไรก็ได้ เปิดดูหรือพิมพ์ออกมาบนเครื่องไหนก็หน้าตาเหมือนกันเป๊ะ เลยเขียนเอกสารชื่อ “The Camelot Project” เสนอแนวคิดที่เรียกว่า Interchange PostScript
พูดง่าย ๆ PDF ก็คือเอาวิธีวาดหน้ากระดาษของ PostScript มาแพ็กเป็นไฟล์ที่หน้าตาตายตัว จุดเริ่มต้นนี้แหละที่ทำให้ PDF แก้ยากมาจนทุกวันนี้ เดี๋ยวผมเล่าต่อในหัวข้อถัดไป
ในไทม์ไลน์ด้านล่าง ปีที่มาจากบล็อกของ Adobe, Library of Congress และ PDF Association มีเอกสารรองรับครับ ส่วนราคา Reader รุ่นแรก ฟีเจอร์ของแต่ละรุ่น และวันที่ 1 ก.ค. 2008 ผมได้มาจากวิกิพีเดียกับเมลลิ่งลิสต์เก่า หาเอกสารของ Adobe มายืนยันไม่ได้ ให้ถือเป็นเรื่องที่เล่ากันมานะครับ
- 1982–1984Adobe และ PostScriptWarnock กับ Geschke ตั้ง Adobe ธันวาคม 1982 แล้วออก PostScript ปี 1984 ขายสิทธิ์ให้บริษัทคอมพิวเตอร์และเครื่องพิมพ์
- 1990–1991โครงการ CamelotWarnock เขียน “The Camelot Project” บล็อกของ Adobe บอกว่าปี 1990 ส่วนตัวเอกสารที่เผยแพร่กันมักลงปี 1991 วันที่แน่นอนผมหาไม่เจอ
- 15 มิ.ย. 1993Acrobat 1.0 และ PDF 1.0Adobe เปิดตัวทั้งสองอย่างพร้อมกัน และเปิดสเปกให้คนอื่นอ่านตั้งแต่วันแรก ช่วงแรกคนใช้น้อย Adobe เล่าเองว่าเพราะรุ่นแรกต้องซื้อ และอินเทอร์เน็ตยุคนั้นโหลดช้า มีรายงานว่า Reader 1.0 ราคาราว 50 ดอลลาร์ ตัวสร้างไฟล์ Distiller ราว 695 ดอลลาร์ แล้ว Reader ก็แจกฟรีตั้งแต่รุ่น 2.0 ราว ก.ย. 1994
- 1994–2006เพิ่มความสามารถทีละรุ่น1.1 ปี 1994 รหัสผ่านและการเข้ารหัส · 1.2 ปี 1996 ฟอร์ม (AcroForm) · 1.3 ปี 2000 ลายเซ็นดิจิทัลและ JavaScript · 1.4 ปี 2001 ความโปร่งใสและ Tagged PDF · 1.5 ปี 2003 JPEG2000 และ object streams ที่ทำให้ไฟล์เล็กลง · 1.6 ปี 2004 3D, AES และ OpenType · 1.7 ปี 2006
- 2005PDF/A-1มาตรฐาน ISO 19005-1 สำหรับเก็บเอกสารไว้อ่านได้อีกนาน ๆ
- 2006เรื่องกับ Microsoft OfficeAdobe คัดค้านที่ Office 2007 จะมี “Save as PDF” ในตัว Microsoft เลยแยกออกมาเป็นส่วนเสริมให้โหลดฟรี (ตามรายงานของ InfoWorld) สหภาพยุโรปมองว่าเป็นเรื่องทรัพย์สินทางปัญญา ไม่ใช่การกีดกันการแข่งขัน พอปี 2009 Office 2007 SP2 ก็ใส่ Save as PDF กลับมาในตัว ส่วนสองบริษัทตกลงกันว่าอะไร ผมหาไม่เจอ
- 29 ม.ค. 2007Adobe ส่ง PDF 1.7 ให้ AIIMAdobe ประกาศส่งสเปก PDF 1.7 ฉบับเต็มให้ AIIM เพื่อนำเข้า ISO
AIIM (ปัจจุบันชื่อเต็มคือ Association for Intelligent Information Management) เป็นสมาคมไม่แสวงกำไร ตั้งขึ้นปี 1944 ทำเรื่องการจัดการเอกสารและข้อมูล สมาชิกมีทั้งบริษัททำซอฟต์แวร์และคนที่ใช้งานจริง ในเรื่องนี้ AIIM เป็นตัวกลางพาสเปกเข้ากระบวนการของ ISO ไม่ได้เป็นเจ้าของ PDF - 2008ISO 32000-1:2008PDF 1.7 กลายเป็นมาตรฐาน ISO วันที่ที่เล่ากันคือ 1 ก.ค.
- 2017 และ 2020PDF 2.0ISO 32000-2 ออกปี 2017 ปรับปรุงปี 2020 มีรายงานว่าฉบับ 2020 ไม่อ้างเอกสารที่เป็นของบริษัทใดแล้ว ส่วน XFA ฟอร์มแบบ XML ของ Adobe ถูกประกาศเลิกใช้ในรุ่นนี้
- เม.ย. 2023อ่านสเปก PDF 2.0 ได้ฟรีPDF Association เปิดให้อ่าน ISO 32000-2 ฟรี (ต้องลงทะเบียน) มี Adobe, Apryse และ Foxit เป็นผู้สนับสนุน
- 2023PDF ทั้งโลกAdobe บอกว่ามี PDF มากกว่า 3 ล้านล้านไฟล์ และปีเดียวมีมากกว่า 400,000 ล้านไฟล์ที่ถูกเปิดใน Acrobat
- 18 มิ.ย. 2026PDF 2.0 Errata Collection 3PDF Association ออกชุดแก้คำผิดในสเปกครั้งที่ 3 ตอนนี้ยังไม่มี PDF 2.1 หรือ 3.0
ทำไม PDF ถึงแก้ยาก เพราะมันเก็บ “หน้ากระดาษ” ไม่ได้เก็บ “เนื้อหา”
ย้อนไปที่เป้าหมายของ Warnock ครับ PDF ถูกสร้างมาให้หน้าตาเหมือนเดิมทุกเครื่อง เหมือนปริ้นต์ลงกระดาษแล้ว ไม่ได้สร้างมาให้แก้ต่อ
ลองนึกภาพตัวอักษรที่ถูกติดกาวลงบนกระดาษทีละตัว แต่ละตัวอยู่ตรงตำแหน่งเป๊ะ แต่ไม่มีอะไรบอกเลยว่าตัวไหนเป็นคำเดียวกัน ตัวไหนอยู่ย่อหน้าเดียวกัน
ข้างในไฟล์ PDF เป็นแบบนั้นจริง ๆ ข้อความคือคำสั่งให้วาดตัวอักษรที่พิกัด x, y ไม่มีสิ่งที่เรียกว่าย่อหน้า บรรทัด หรือคำ บางบรรทัดยังถูกหั่นเป็นหลายชิ้นเพราะการจัดระยะตัวอักษร
โปรแกรมแก้ PDF จึงต้องเดาเองว่าอะไรคือย่อหน้า และหลายโปรแกรมก็ใช้วิธีง่าย ๆ คือปิดข้อความเดิมไว้ แล้ววาดข้อความใหม่ทับลงไป
เทียบง่าย ๆ
- Word เก็บเนื้อหา มีย่อหน้า มีคำ แก้แล้วจัดบรรทัดใหม่ให้เอง
- PDF เก็บหน้ากระดาษ เหมือนภาพถ่ายที่ยังเลือกตัวอักษรได้
- โปรแกรมแก้ PDF ต้องเดาโครงสร้างกลับมาก่อน ถึงจะแก้ให้ได้
ฟอนต์ ป้ายตัวอักษร และไฟล์สแกน
ปัญหาถัดมาคือฟอนต์ PDF ส่วนใหญ่ฝังฟอนต์ไว้แค่บางส่วน (font subset) คือเก็บเฉพาะตัวอักษรที่เอกสารใช้จริง ถ้าเราพิมพ์ตัวที่ไม่มีในไฟล์ โปรแกรมก็วาดไม่ได้ หรือไปใช้ฟอนต์อื่นแทน และ Acrobat เองก็ต้องมีฟอนต์นั้นในเครื่องถึงจะแก้ด้วยฟอนต์เดิมได้
อีกเรื่องคือรูปตัวอักษร (glyph) ในไฟล์ไม่ได้บอกตัวเองว่าเป็นตัวอะไร ต้องพึ่งตาราง ToUnicode ที่จับคู่รูปกับตัวอักษร ถ้าตารางนี้หายหรือผิด ตาเราเห็นปกติ แต่คัดลอกหรือค้นหาจะได้ขยะ ฟอนต์บางตัวเก็บรูปไว้ในช่วง Private Use Area (U+E000 ถึง U+F8FF) ซึ่งก็ให้ผลแบบเดียวกัน
ส่วน PDF ที่ได้จากการสแกน ข้างในเป็นรูปภาพล้วน ไม่มีตัวอักษรเลย ต้องทำ OCR ก่อนถึงจะค้นหรือคัดลอกได้
รหัสผ่านกับลายเซ็น
แฟล็ก “ห้ามคัดลอก ห้ามแก้ไข” ใน PDF ที่ใส่รหัสผ่านไว้ เป็นแค่คำขอครับ โปรแกรมเลือกเองว่าจะทำตามหรือไม่ (ตามเอกสารของ pikepdf) ผมเล่าให้รู้ว่ามันทำงานแบบนี้ ไม่ได้สอนวิธีเลี่ยงนะครับ
ไฟล์ที่เซ็นลายเซ็นดิจิทัลแล้ว ถ้าไปแก้ทีหลังจะเห็นว่ามีการเปลี่ยนแปลง PDF 2.0 ยอมให้เพิ่มบางอย่างหลังเซ็นได้ เช่น ตราประทับเวลา
แล้วทำไมภาษาไทยยากกว่าภาษาอื่น
ทุกข้อข้างบนเจอทุกภาษา แต่ภาษาไทยมีเรื่องของตัวเองเพิ่มอีกสี่ข้อ ที่ผมหาหลักฐานเจอ
สระ ำ ถูกวาดเป็นสองรูปเอกสารของ Microsoft เรื่องการจัดรูปภาษาไทยบอกว่า ำ (U+0E33) ถูกวาดเป็นนิคหิต ํ กับสระ า พอโปรแกรมแปลงกลับเป็นข้อความ เลยมักได้ ำ ผิด คำอย่าง “น้ำ” จึงพังบ่อย
วรรณยุกต์และสระบนล่างเป็นรูปที่วางตามตำแหน่งพอลงไปอยู่ใน PDF ทุกตัวกลายเป็นรูปแยกชิ้น แปลงกลับเป็นข้อความแล้วอาจสลับลำดับหรือตกหล่น บั๊กหมายเลข 59576 ของ OpenOffice เป็นตัวอย่างชัด คัดลอกภาษาไทยจาก PDF ที่ส่งออกบน Windows แล้วตัวอักษรที่ไม่ใช่ตัวแรกของแต่ละกลุ่มหายไป ในบั๊กเดียวกันยังมีโปรแกรมเขียนไฟล์ที่จับรูปสระ า ไปเป็น ำ ด้วย
ฟอนต์ไทยรุ่นเก่าเก็บรูปไว้นอกมาตรฐานในเมลลิ่งลิสต์ Unicode ปี 2003 มีการพูดถึงฟอนต์ไทยรุ่นเก่าที่เก็บรูปวรรณยุกต์และสระที่ขยับตำแหน่งไว้ใน Private Use Area (ช่วง U+F700) ข้อความที่คัดลอกออกมาเลยเป็นอักขระแปลก ๆ ที่เราเรียกกันว่า “ภาษาต่างดาว” โครงการ bact/constitution บน GitHub ตอนดึงข้อความรัฐธรรมนูญจาก PDF ก็ต้องเรียงวรรณยุกต์กับสระใหม่ และตัดอักขระพวกนี้ทิ้ง
ภาษาไทยไม่เว้นวรรคระหว่างคำถ้าโปรแกรมต้องจัดบรรทัดใหม่หลังแก้ มันต้องรู้ว่าคำขาดตรงไหน ไม่งั้นบรรทัดจะตัดกลางคำ
เรื่องนี้ไม่ได้เกิดแค่ในทฤษฎีครับ ใน Adobe Community เมื่อ 27 ก.ย. 2021 มีคนรายงานว่าวรรณยุกต์และสระบนล่างของภาษาไทยเลื่อนไปทางซ้ายใน Acrobat เจ้าหน้าที่ Adobe ขอไฟล์ตัวอย่างไป แล้วกระทู้ก็ปิด ผมไม่เห็นว่ามีวิธีแก้
ใน Pantip ก็มีกรณีที่ใช้ TH Sarabun New แล้วสั่ง Create PDF ผ่าน Acrobat ตัวอักษรหายบางส่วน แต่ Save As PDF ของ Word เองกลับปกติ เดี๋ยวผมเล่าเต็ม ๆ ในหัวข้อ Pantip ครับ
PDF เป็นลิขสิทธิ์ของ Adobe ไหม Adobe คิดขึ้น แต่วันนี้เป็นมาตรฐาน ISO แล้ว
Adobe เป็นคนคิด PDF อันนี้จริงครับ แต่ตั้งแต่ปี 2008 ตัวฟอร์แมตกลายเป็นมาตรฐาน ISO 32000 ไม่ได้เป็นของบริษัทไหนคนเดียวแล้ว
ต้องแยกให้ออกก่อนว่าลิขสิทธิ์คุ้มครองอะไร ลิขสิทธิ์คุ้มครองตัวเอกสารและตัวโปรแกรม เช่น Acrobat แต่วิธีเก็บข้อมูลในไฟล์ PDF ตอนนี้เขียนอยู่ในมาตรฐาน ISO ตัวหนังสือมาตรฐานนั้น ISO ขายเอง ส่วน PDF 2.0 อ่านได้ฟรีผ่าน PDF Association
ที่เคยได้ยินว่า “Adobe เปิด PDF เป็นโอเพนซอร์สปี 2008” อันนี้ Adobe พูดเองครับ แต่ผมว่าใช้คำหลวมไปหน่อย สิ่งที่เกิดขึ้นจริงคือ Adobe ส่งสเปกเข้า ISO และให้สัญญาสิทธิบัตร ไม่ได้เปิดโค้ดโปรแกรมใด ๆ
ผมว่าเป็นการตัดสินใจที่ใจกว้างนะครับ เพราะเป็นเหตุผลที่ PDF เปิดได้ทุกเครื่องมาจนวันนี้
คำตอบสั้น
- Adobe คิด PDF ใช่
- ฟอร์แมตเป็นของ Adobe ตอนนี้ไหม ไม่ใช่ เป็นมาตรฐาน ISO 32000 ตั้งแต่ปี 2008
- ใครเขียนโปรแกรม PDF ก็ได้ ตามสัญญาสิทธิบัตรของ Adobe
- ชื่อ Acrobat, Reader และโลโก้ Adobe PDF เป็นเครื่องหมายการค้าของ Adobe
คำว่า PDF เฉย ๆ เป็นเครื่องหมายการค้าไหม
หน้าเครื่องหมายการค้าของ Adobe มี “Adobe PDF” กับโลโก้ Adobe PDF แต่ผมไม่เห็นคำว่า “PDF” เฉย ๆ ในหน้านั้น เลยยืนยันไม่ได้ว่าเป็นเครื่องหมายที่ Adobe จดไว้ ที่แน่ ๆ คือ Acrobat, Reader และโลโก้ Adobe PDF
ส่วนที่ยังผูกกับ Adobe คือ XFA
มีอยู่ส่วนหนึ่งที่ไม่ได้อยู่ในมาตรฐาน ISO คือ XFA ฟอร์มแบบ XML ของ Adobe กับ Acrobat JavaScript ทั้งสองอย่างมีสเปกอยู่บนเว็บ Adobe
XFA ถูกประกาศเลิกใช้ใน PDF 2.0 แล้ว แต่ฟอร์มเก่าของหน่วยงานรัฐและธนาคารยังใช้อยู่ และเป็นที่รู้กันว่าฟอร์มแบบนี้เปิดได้ครบเฉพาะใน Adobe Reader ใครโหลดฟอร์มราชการมาแล้วเปิดในโปรแกรมอื่นไม่ขึ้น ลองเปิดด้วย Reader ดูครับ
Adobe อนุญาตอะไรบ้าง ทำโปรแกรม PDF ได้ฟรี ใช้ Reader ได้ฟรี แต่ชื่อกับโลโก้ยังเป็นของเขา
เอกสารที่สำคัญที่สุดคือ Public Patent License ที่ Adobe ออกสำหรับ ISO 32000-1 ครับ อนุญาตให้ทุกคนสร้าง ใช้ ขาย และแจกจ่ายโปรแกรมที่อ่าน เขียน หรือแก้ PDF ที่ตรงตาม ISO 32000-1 ได้โดยไม่ต้องจ่ายค่าสิทธิ์
มีเงื่อนไขอยู่ข้อเดียว คือถ้าใครไปฟ้อง Adobe ว่าการทำโปรแกรมตามมาตรฐานนี้ละเมิดสิทธิบัตรสำคัญของ Adobe ทาง Adobe เพิกถอนสิทธิ์ของคนนั้นได้ สัญญานี้ครอบคลุมเฉพาะ ISO 32000-1 ส่วนของ PDF 2.0 ผมหาเอกสารแบบเดียวกันไม่เจอ เลยไม่ขอพูดแทน
เพราะสัญญาแบบนี้แหละครับ Foxit, ตัวดู PDF ใน Chrome และ Edge, Preview บน Mac, LibreOffice, pdf.js และ HippoCraft ของผม ถึงเขียนขึ้นมาได้โดยไม่ต้องไปขอ Adobe
รวมเรื่องที่ Adobe อนุญาตไว้ในตารางเดียว ส่วนเรื่องไอคอน PDF ผมยืนยันจากต้นทางได้ไม่ครบนะครับ
| เรื่อง | อนุญาตไหม และเงื่อนไข |
|---|---|
| เขียนโปรแกรมที่อ่าน เขียน แก้ PDF | ได้ ไม่เสียค่าสิทธิ์ ตาม ISO 32000-1 และ Adobe เพิกถอนได้ถ้าฟ้อง Adobe เรื่องสิทธิบัตร (Adobe Public Patent License) |
| ใช้ Acrobat Reader | ใช้ฟรี Adobe เขียนว่า “free and available for volume distribution” (หน้า Distribute ของ Adobe) |
| แจก Reader ในองค์กรหรือรวมไปกับอุปกรณ์ | ต้องมีสัญญา ต้องมี Distribution License Agreement เมื่อติดตั้งผ่านอินทราเน็ต/LAN หรือรวมไปกับซีดีหรือฮาร์ดแวร์ (หน้า Distribute ของ Adobe) |
| ใช้ไอคอนไฟล์ PDF บนเว็บตัวเอง | ได้ ใช้บอกว่าลิงก์ไปไฟล์ PDF ห้ามดัดแปลงไอคอน และ Adobe เพิกถอนได้ (หน้า Linking ของ Adobe) |
| ชื่อ Acrobat, Reader, โลโก้ Adobe PDF | เป็นเครื่องหมายการค้าของ Adobe มีเงื่อนไขการใช้ละเอียด ผมยังไม่ได้อ่านครบ (หน้าเครื่องหมายการค้าของ Adobe) |
| ใช้ Acrobat Pro / Standard | ต้องจ่าย เป็นแบบสมัครสมาชิก คนใน Pantip บ่นว่าไม่มีแบบซื้อขาด และหลายกระทู้เล่าว่ายกเลิกก่อนครบสัญญาโดนค่าธรรมเนียม (กระทู้ Pantip ดูหัวข้อถัดไป) |
คนไทยเจอปัญหาอะไรจริง อันดับหนึ่งคือแปลงเป็น Word แล้วภาษาไทยเพี้ยน
ผมค้นใน Pantip ได้กระทู้ที่ตรงเรื่องราว ๆ 70 กระทู้ แบ่งได้ 10 กลุ่ม
ตัวเลขในตารางนับจากผลค้นหา 10 อันดับแรกของแต่ละกลุ่ม เลยใช้ดูแนวโน้มได้ แต่ไม่ใช่สถิติจริงนะครับ และเพราะ Pantip ไม่แสดงวันที่โพสต์ชัด ๆ ผมเลยไม่ใส่ปีของกระทู้
| ลำดับ | ปัญหา | กระทู้ (โดยประมาณ) |
|---|---|---|
| 1 | แปลง PDF เป็น Word หรือคัดลอกแล้วภาษาไทยเพี้ยน | 14 |
| 2 | แก้ข้อความไทยใน PDF และหาทางเลือกฟรี | 14 |
| 3 | ไฟล์ใหญ่เกินไป | 8 |
| 4 | ติดรหัสผ่านหรือถูกล็อก | 8 |
| 5 | ฟอนต์หาย กลายเป็นกล่อง (TH Sarabun) | 7 |
| 6 | PDF สแกนและ OCR ภาษาไทย | 6 |
| 7 | เซ็นเอกสาร | 5 |
| 8 | ความปลอดภัยของเว็บแปลงไฟล์ออนไลน์ | 5 |
| 9 | ราคาและการสมัครสมาชิก Acrobat | 5 |
| 10 | ฟอร์มราชการพิมพ์ภาษาไทยไม่ได้ | 5 |
ที่น่าสนใจคือคำถามพวกนี้วนมาเรื่อย ๆ เป็นสิบปี กระทู้เก่าสุดที่ผมเจอในคลังกระทู้เก่าคือปี 2006 ถามว่า “ใช้กับภาษาไทยได้ 90 เปอร์เซนต์”
กระทู้ที่ผมเปิดอ่านเอง
ข้อความในเครื่องหมายคำพูดยกมาจากกระทู้ตรง ๆ ครับ
คัดลอกลง Notepad แล้วก็ยังเพี้ยน“ลองcopy ลง notepad ลองเว็บencoding online แล้ว ก็ไม่หายค่ะ” คำตอบอันดับต้นแนะนำให้ใช้ Acrobat Reader เมนู Edit แล้ว Copy File to Clipboard แล้วไปวางใน Word 2010 กระทู้ 31246950
อยากได้ Word ที่ไม่เพี้ยน“จากข้อความ pdf เป็น word แบบไม่เพี้ยน” กระทู้นี้ไม่มีใครตอบ กระทู้ 42790821
อยากพิมพ์ไทยต่อจากข้อความเดิมอยาก “Edit ข้อความเดิม โดยเพิ่มข้อความตัวหนังสือภาษาไทยต่อไปได้” คำตอบแนะนำ Acrobat และ ABBYY FineReader กระทู้ 39356636
แก้แล้วตัวหนังสือห่าง“พิมพ์แก้ไขใน pdf แล้วภาษาไทยห่างกัน” ลองเปลี่ยนฟอนต์แล้วก็ไม่หาย ไม่มีคำตอบ กระทู้ 23089394
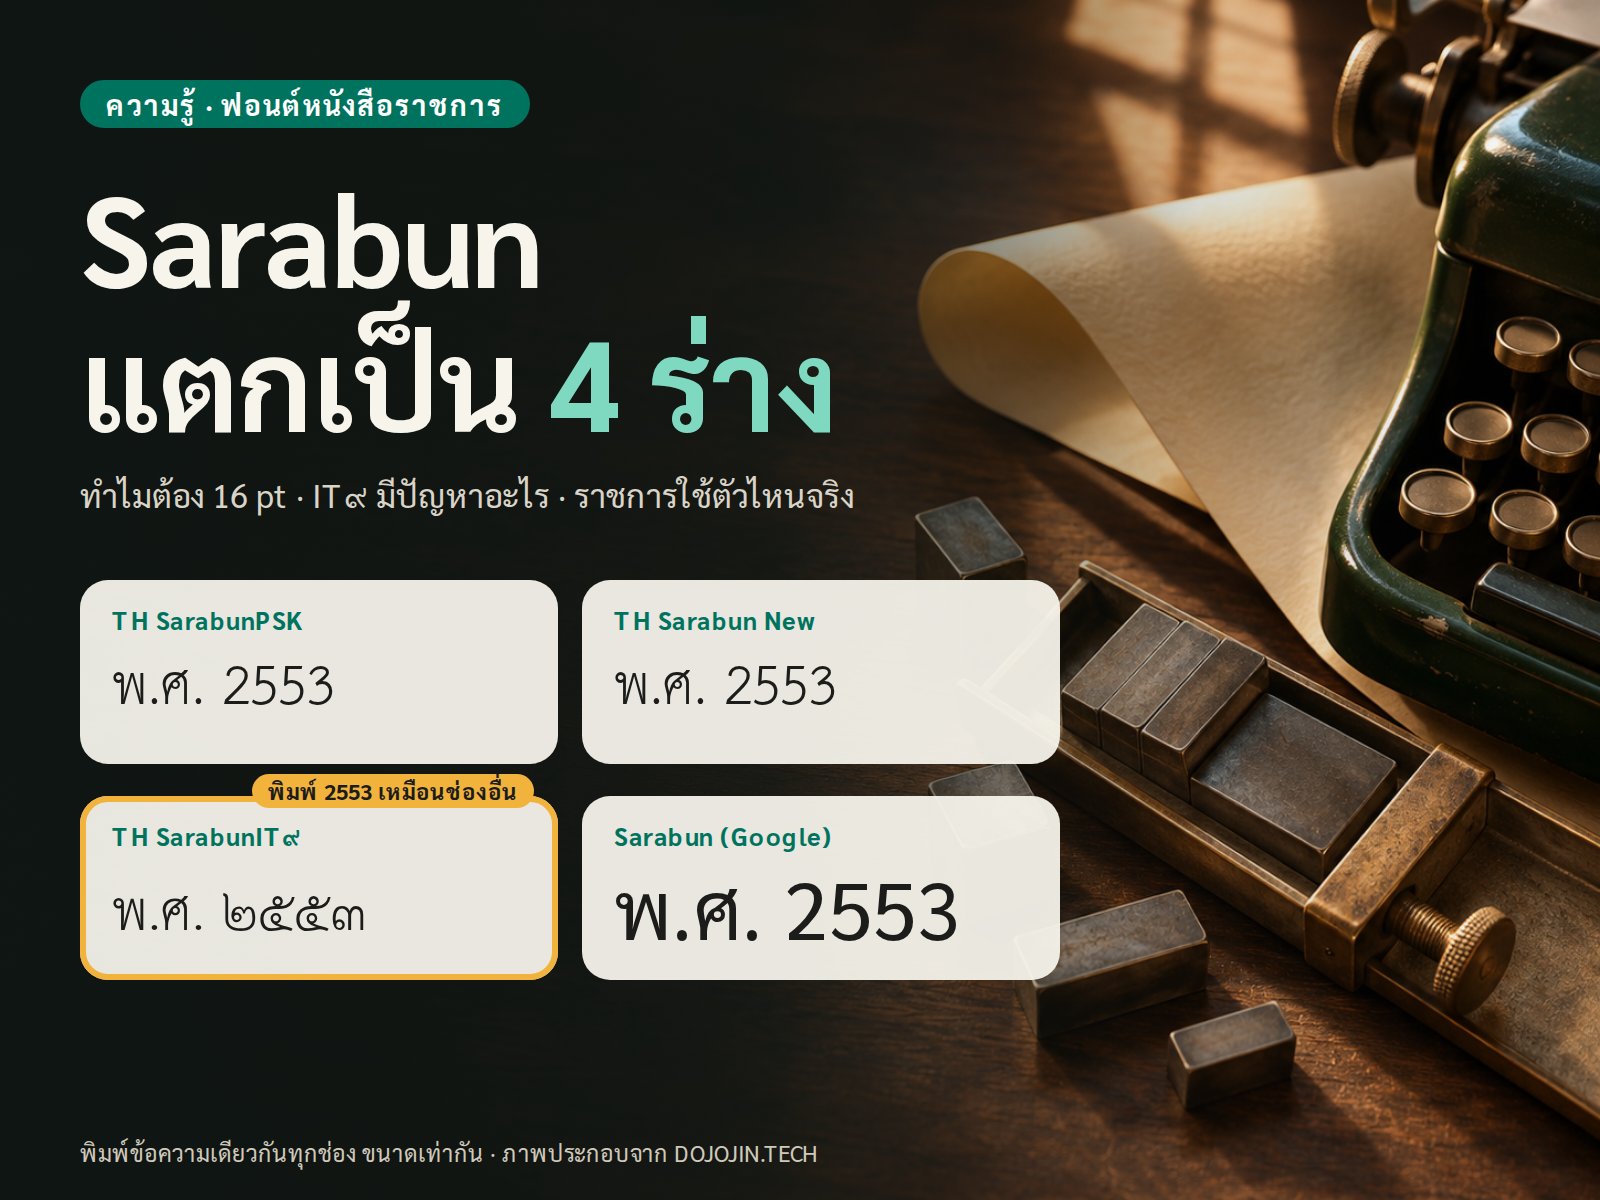
วรรณยุกต์กลายเป็นกล่อง“พวกวรรณยุกต์ มันจะกลายเป็นสี่เหลี่ยม” ใช้ Windows 10, Office 2016 กับ TH Sarabun PSK ดูตัวอย่างก่อนพิมพ์ปกติ แต่พิมพ์ออกมาเป็นกล่อง วิธีแก้ที่ตอบกันคือติดตั้งฟอนต์ใหม่ หรือเปลี่ยนไปใช้ TH Sarabun New กระทู้ 37932426
Create PDF ของ Acrobat ทำตัวอักษรหายใช้ TH Sarabun New แล้ว “ตัวอักษรหายไปบางส่วน เช่นพวกวงเล็บหาย” หลังสั่ง Create PDF จาก Acrobat แต่ Save As PDF ของ Word ปกติ กระทู้ 39408952
อีกสามกระทู้เล่าเรื่องคนละมุมครับ
มีคนถามว่าเว็บแปลงไฟล์ “small pdf … ปลอดภัยไหมครับ” (กระทู้ 38517696) ซึ่งเป็นคำถามที่ดีมาก
อีกกระทู้บ่นเรื่อง Acrobat Pro ว่า “แถมไม่มีซื้อแบบถาวร” ผู้ตอบบอกว่าลูกค้าส่วนใหญ่ของ Adobe เป็นองค์กร (กระทู้ 40920350)
และอีกกระทู้ที่เจอบ่อยกับฟอร์มราชการ “ดาวโหลดฟอร์มจากทางราชการมา แต่พิมพ์ไทยไม่ได้” (กระทู้ 30546735)
เรื่องที่ผมอ่านแล้วเอะใจ
กระทู้ใบรับรองดอกเบี้ยธนาคารที่ติดรหัสผ่าน (กระทู้ 40464249) คำตอบอันดับต้นแนะนำให้ใช้เว็บปลดรหัสผ่านออนไลน์ แปลว่าเอาเอกสารธนาคารของเราไปอัปโหลดขึ้นเว็บที่ไม่รู้จัก ตรงนี้ผมว่าต้องคิดให้ดีก่อนครับ
ทำ PDF ภาษาไทยให้ไม่พัง เริ่มที่ต้นทาง
อ่านมาถึงตรงนี้คงเห็นแล้วว่า แก้ PDF ทีหลังยากกว่าทำให้ถูกตั้งแต่แรกเยอะ ผมสรุปจากที่ไล่มาทั้งหมดไว้แบบนี้ครับ
- ส่งออกจาก Word ด้วย Save As PDF ในกระทู้ที่เจอ Save As PDF ของ Word เก็บ TH Sarabun New ไว้ครบ แต่ Create PDF ผ่าน Acrobat ทำตัวอักษรหาย (ผมไม่ได้ลองเองทุกเวอร์ชัน)
- เช็กว่าฟอนต์ถูกฝังไว้ เปิดไฟล์ใน Acrobat Reader ไปที่ File แล้ว Properties แท็บ Fonts ทุกฟอนต์ควรขึ้นว่า Embedded หรือ Embedded Subset ถ้าไม่ขึ้น เครื่องที่ไม่มีฟอนต์นั้นจะเห็นเป็นฟอนต์อื่น
- ใช้ฟอนต์ยูนิโค้ด อย่าง TH Sarabun New หรือ Sarabun คัดลอกและค้นหาจะได้ถูก
- เก็บไฟล์ต้นฉบับไว้เสมอ แก้ที่ Word แล้วส่งออกใหม่ ง่ายกว่าแก้ PDF มาก
- เอกสารลับอย่าอัปโหลดขึ้นเว็บแปลงไฟล์ ถ้าเลี่ยงได้ ใช้โปรแกรมที่ทำงานในเครื่อง
- เก็บไว้นาน ๆ ใช้ PDF/A เป็นมาตรฐานที่ทำมาเพื่อการเก็บเอกสารโดยตรง
- ไฟล์สแกนต้องทำ OCR ก่อนถึงจะค้นหาและคัดลอกได้
ถ้าต้องส่งให้คนอื่นแก้
บอกเขาว่าใช้ฟอนต์อะไร และส่งไฟล์ต้นฉบับไปด้วยถ้าทำได้ ไม่งั้นเขาต้องมานั่งเดาโครงสร้างจาก PDF เหมือนที่เล่าไว้ข้างบน
ผมเลยทำ HippoCraft
ปัญหาแบบนี้แหละครับที่ทำให้ผมทำ HippoCraft เป็นโปรแกรมแก้ PDF ภาษาไทยแบบโอเพนซอร์ส เขียนด้วย Rust ทำงานในเครื่อง ไม่อัปโหลดไฟล์ไปไหน
Acrobat กับ Foxit ก็เป็นโปรแกรมที่ดีครับ เลือกตามงานของแต่ละคนได้เลย ใครอยากลองดูได้ที่ หน้า HippoCraft
ขอบคุณที่อ่านจนจบครับ
แหล่งอ้างอิง
- PostScript: Computer History Museum, PostScript: A Digital Printing Press (1 ธ.ค. 2022)
- AIIM: AIIM, About us
- ประวัติและโครงการ Camelot: The Camelot Project (Warnock) · Adobe Blog, ใครสร้าง PDF · Adobe Blog, 30 ปี Acrobat
- Library of Congress: PDF/A-1 · ISO 32000-1
- PDF Association: อ่าน ISO 32000-2 ฟรี · PDF 2.0 Errata Collection 3
- Microsoft และ Adobe, เรื่อง Office: InfoWorld · Microsoft, Save as PDF ใน SP2
- สัญญาและเครื่องหมายการค้า: Adobe Public Patent License (ISO 32000-1) · เครื่องหมายการค้า Adobe · Distribute Acrobat Reader · Adobe Linking (ไอคอน PDF)
- ทำไมแก้ยาก: IDRsolutions · pdf-tools, font subsetting · PDFTron, ToUnicode · pikepdf, security
- ภาษาไทยใน PDF: Microsoft, Thai shaping · OpenOffice bug 59576 · Unicode mailing list 2003 · bact/constitution · Adobe Community (27 ก.ย. 2021)
- Pantip: 31246950 · 42790821 · 39356636 · 23089394 · 37932426 · 39408952 · 38517696 · 40920350 · 40464249 · 30546735
- บทความและโปรเจกต์ที่เกี่ยวข้องในเว็บนี้: ฟอนต์หนังสือราชการไทย · HippoCraft
- ภาพปก: by dojojin.tech
- การสำรวจ Pantip: ค้นหากระทู้ที่ตรงเรื่อง 70 กระทู้ 10 กลุ่ม ตัวเลขเป็นค่าประมาณจากผลค้นหา 10 อันดับแรกของแต่ละกลุ่ม